TL;DR
同一个模型在不同硬件、软件或量化设置下运行,输出的 token 会出现差异,导致性能和工具调用出错,但这不是模型本身变笨。
有人吹某个模型“神了”,本地一跑却感觉“就这?”——原因可能不是模型差,而是跑法不同。研究者在不同设置下对比了同一个模型的输出,发现了惊人的差异。
1. 换一个“注意力后端”,输出就变了
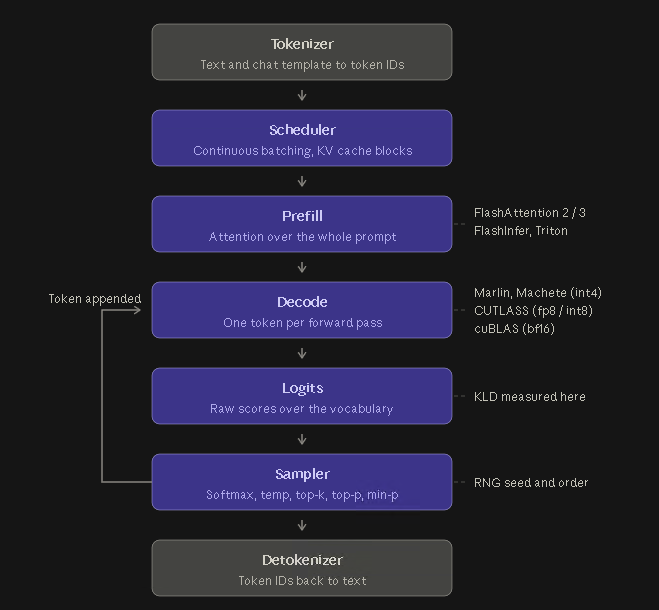
模型在计算下一个 token 时,有多种底层实现可选,比如 FlashAttention 2、Flash Inference 和 Triton。测试发现,仅切换这个选项,在长上下文中,模型选词的“主见”就会不同。
同一个 GPU、同样的提示词,换后端后,最可能的那个 token 有约 40% 的几率改变(在长上下文中)。这种差异是随机的,还是与提示内容相关?结果显示,差异比想象中更常见。
更关键的是,这种差异会导致工具调用出错:比如本该执行“show arp”,却执行了“show run”。一个简单的配置选择,就能让模型“犯错”。
2. 量化程度越高,模型越“浪”
量化是压缩模型以节省内存,但精度会下降。测试对比了不同量化方案:BF16 基准、FP8、INT8、NVFP4、AWQ。结果,INT8 与 BF16 相差最小,NVFP4 的“token 翻转”率最高,接近 50%——几乎每两个词就换一个。
高量化还导致更严重的问题:在长上下文(超过 40k token)中,模型会“忘记”上下文,甚至出现重复输出。在工具调用中,NVFP4 和 AWQ 都可能执行错误命令,导致任务失败。
3. 量化并非一无是处,但“开箱即用”有风险
作者发现,不是所有量化都差。在“越狱”类模型中,一些精心设计的量化(如 WildCard)在保持“无审查”能力的同时,对工具调用的影响较小。但像 NVFP4 这类,不仅精度差,还会破坏工具调用。
所以,选模型时,不要只看基准分数,要实测你的任务。如果用到工具或长上下文,优先选高精度(如 INT8),避免太低比特的量化。
总之,模型本身不“笨”,是你的跑法让它“犯傻”。配置不同,结果天差地别。
从全球优质信息源中筛选,几分钟了解当天最值得关注的观点。

