TL;DR
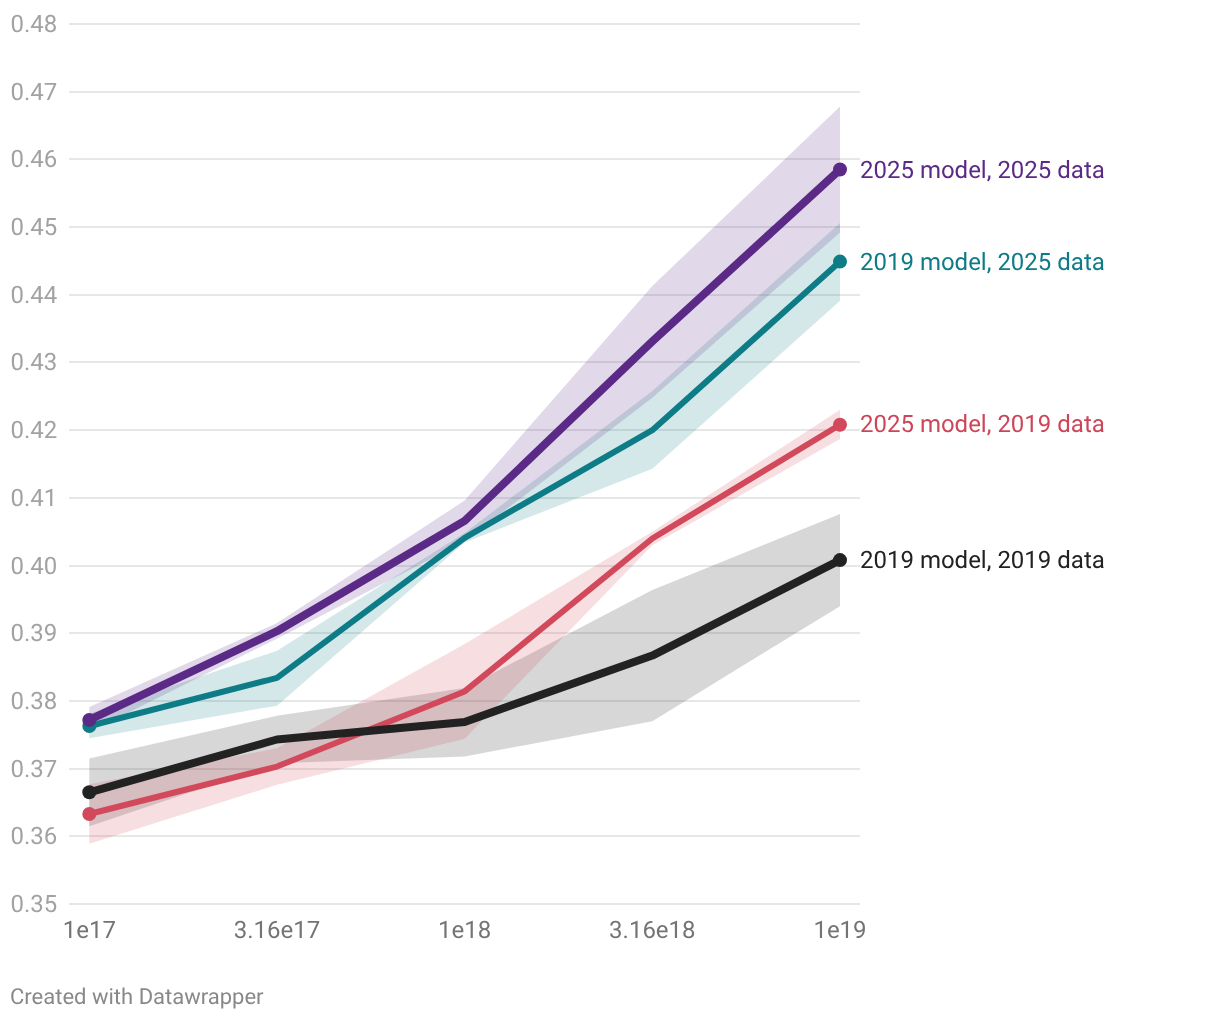
2019 至 2025 年预训练效率提升中,数据改进贡献了 12 倍,远超模型的 3.7 倍,但模型的真正价值在于让更大规模的计算成为可能。
大家都以为 AI 变聪明主要靠模型升级,但一项新研究发现:过去六年里,预训练的进步大头来自数据——把 2019 年的模型配上 2025 年的数据,表现远超 2025 年的模型配 2019 年的数据。
作者把每年公开的模型配方和数据配方交叉训练,比较它们在综合测试上的表现。结果很惊人:数据改进带来的效率提升是模型的 3 倍多。
模型的功劳:让大船能开
但别急着说模型没用。模型的真正贡献不是少用算力,而是让算力能越堆越多——梯度爆炸、内存不够、训练太慢,全是模型研究在解决。没有这些,数据再多也跑不动。
以后还有料可装吗
这引出一个要命的问题:数据改进像是在吃老本——网上的数据是有限的,再会挑也挑不出新东西。合成数据能不能补上,是接下来的关键。
一句话:对预训练而言,会挑数据比会调模型更划算,但能装多少货,还得看船够不够大。
从全球优质信息源中筛选,几分钟了解当天最值得关注的观点。

