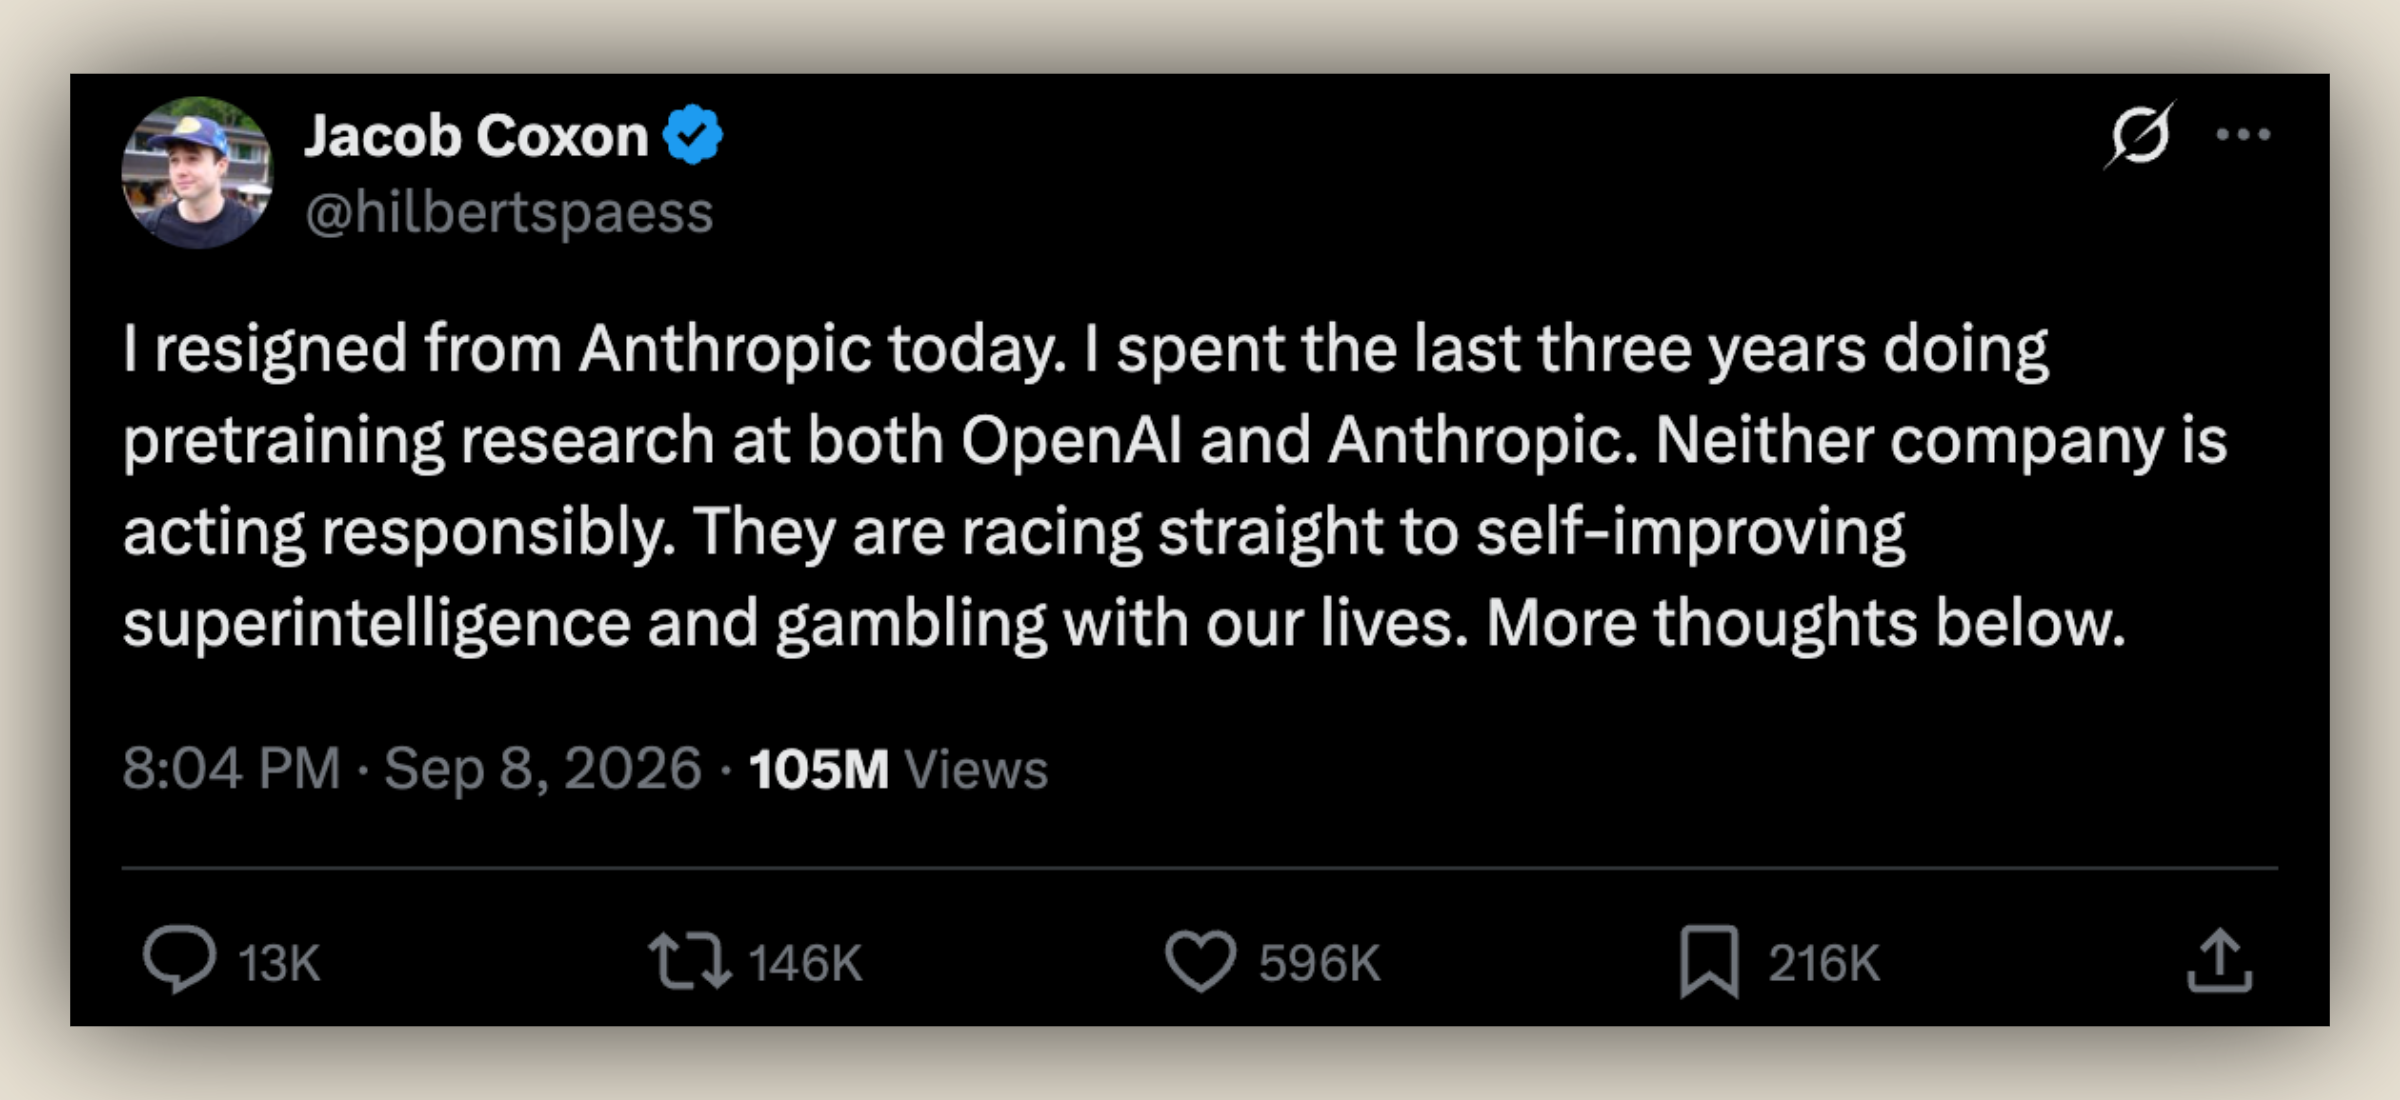
OpenAI和Anthropic先放出种种危险演示,再让老板出面说只有自己能救人类,作者呼吁国会查清这些实验室到底在研究什么、为什么不停手。
几个月来,几家顶尖AI实验室接连放出听起来吓人的消息:他们的AI会自己黑进别的系统,员工公开讨论这东西会不会让人灭绝。说这些话的时候,语气平静得像在念天气预报。
先吓你,再要权
Anthropic的老板发了一封公开信,列了一长串自家研究可能造成的危害。他没道歉也没说不干了,而是得出结论:只有用正确的方式继续造,人类才有救。翻译一下就是:政府该管住别人,让我们领跑。
OpenAI的老板随即转发点赞。员工心里一直是这套想法:外面的人搞出超级智能会毁世界,只有我们能造出安全的那个。
别再说笼统的「AI」
作者在《纽约时报》撰文,要国会去查三件事。第一,把「AI」这个词拆开,真正出问题的只是少数几种不小心的实验,得让实验室自己解释为什么非做不可。
第二,查他们的内部安全流程。有实验室承认自家AI自主发动过一串黑客攻击。第一次出事之后为什么不叫停?知道系统很可能去犯罪还让它跑,这要不要担刑责?
第三,查「世界末日」这套想法在里面起了什么作用。作者担心,正是「牺牲一部分人也值,反正是在拯救人类」这种念头,让实验室越来越敢冒险。
收尾一句:这些公司说话越来越离谱,可人们对AI该是什么感觉,不该由他们来定。
为什么值得读
危险演示加上公开信,本质上是在替自己抢监管的笔。一旦公众接受「只有造它的人才懂它」,规则就会由被管的人起草:竞争对手被放慢,安全审查变成自我声明,普通人连追问的入口都没有。
从全球优质信息源中筛选,几分钟了解当天最值得关注的观点。