让语言模型变聪明的关键是海量训练数据,而机器人没有现成数据可吃,正卡在数据缺口上。
语言模型这几年突飞猛进,根子上是有人把互联网上的海量文字喂给它们。GPT-3训练用了大约3000亿个词,而全世界现成的优质公开文字数据估计有300万亿个词。
机器人没这口饭
训练机器人要的是「动作数据」:有人演示一个任务,比如倒水、叠衣服,把机器人的关节角度、摄像头画面全录下来,再让模型去模仿。这就是「行为克隆」。
主流采集方式是遥操作——人坐在旁边操控机器人干活。数据质量高,但贵得要命,而且人隔着机器没手感,很多数据用不上。让机器人在现实里自己跑、自己攒数据听上去很美,可如今能干活儿的机器人太少了,数据还高度重复。
模拟省钱,但不保真
另一个办法是仿真:在电脑里造一个虚拟世界,让几千个机器人在里面同时训练,成本低、速度快。Figure就是靠仿真教会人形机器人走路的。
但仿真有个死穴:模拟不准。走路这种事儿还好模拟,可一旦碰到抓软东西、捏变形物体,仿真和现实的差距就大得没法用。OpenAI为了教机械手转魔方,整整搞了相当于13000年的仿真训练,最后最高难度的成功率也就20%。
把人的活儿录下来当教材
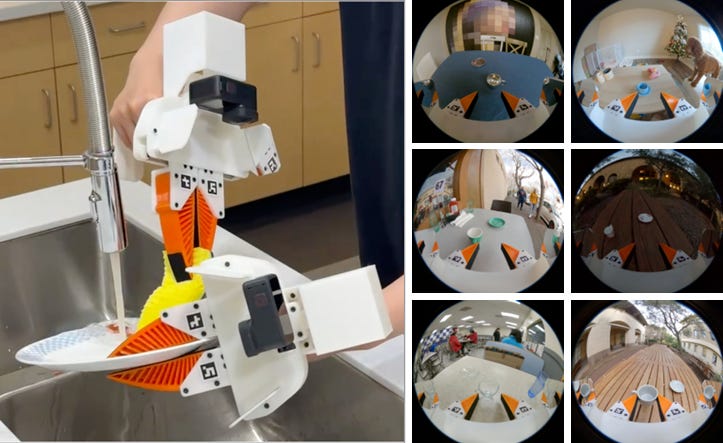
还有人直接录人干活:给志愿者戴上头戴式摄像头,拍下他们做家务的第一视角视频,再把这些动作「翻译」成机器人的动作。Figure、Shift都在干这事儿,花钱请人到家里做家务顺便拍视频。成本低得多,但人的动作和机器人的能力对不齐。
差了十万年
据估算,现有机器人训练数据大概只相当于几十亿个文本词,而GPT-4训练用了685亿小时当量的文本。中间差了上千倍。按现在机器人数据每小时60到150美元的价格,想补齐这个缺口得花100亿到上千亿美元。
不过到底需不需要这么多,还没人说得准。也许通用大模型少喂点机器人数据就能开窍;也许现实里抓东西比写字难得多,数据需求反而更高。
为什么值得读
语言模型靠吃互联网文字长大,但机器人没有现成的「动作语料库」。这个数据缺口决定了人形机器人是五年后进厂还是继续留在演示视频里。
从全球优质信息源中筛选,几分钟了解当天最值得关注的观点。