Anthropic 的研究者用直接篡改神经网络的方式向语言模型注入念头,20% 的试验里模型准确报告了被注入的概念,对照组从不误报。
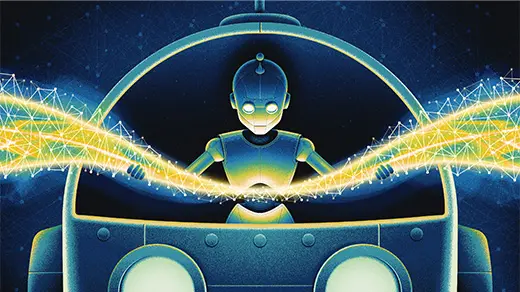
Anthropic 的 Jack Lindsey 做了场数字脑外科手术:把「念头」直接拨进语言模型内部,问它有没有察觉。最强版本的 Claude 在 20% 的试验里答对了,对照组一次也没误报。
后续研究把答案拆细了。模型似乎只能察觉「有东西不对劲」,说不出具体是什么——检测异常和说出内容,是两件彼此独立的事。
可谁训练过它们这本事呢?训练时从没人动过它们的神经活动。
从全球优质信息源中筛选,几分钟了解当天最值得关注的观点。