2014年为英法翻译设计的“注意力”机制,成了大语言模型的核心,而参与设计Transformer的琼斯现在认为,它远不是智能的全部。
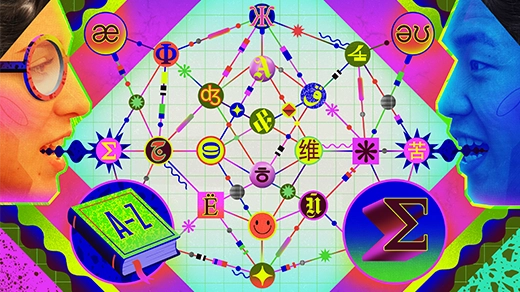
2014年,蒙特利尔一个实习生在做英法机器翻译。当时的模型要把整句话硬塞进固定记忆,句子一长就译不好。
实习生巴达瑙的办法是:翻译每个词时都回头扫视原句,挑出最相关的词参考,这就是“注意力”。长句子因此也能译准。
一个代词引出的问题
难点之一是代词。“动物没过马路,因为它太累了”里的“它”指动物,法语要用阳性的il;“马路太宽了”里的“它”指街道,则要用阴性的elle。
注意力让每个词从句中其他词收集信息。模型靠万亿次修正,自己学会了“动物会累、街道可以宽”这类关联,没人手把手教。
2017年,谷歌团队的Transformer把注意力发挥到极致,此后ChatGPT等大语言模型接连出现。
翻译下一个词,只是“预测下一个词”的一个子任务。模型读遍网络、反复猜词,就得学会翻译、算术和常识。Sakana AI的琼斯认为,这大概是目前离“智能”定义最近的东西。
发明者自己不买账
但琼斯现在认为,注意力并不是全部。人脑没读过整个互联网,耗能也小得多,却能流畅对话。
人的思考也不只是语言,还调用感官、经验和记忆。琼斯说:“现在的范式解决不了效率问题,你得跳到非常不同的东西上去。”
机器把“it”译对,已经让人吃惊;它到底懂不懂,连造它的人也还在争。
为什么值得读
判断AI离智能还有多远,要看它的瓶颈在哪:如果只差更多数据和算力,那就是一条路;如果像琼斯说的要换一种范式,那么模型规模扩张得再快,也不等于在通向智能。
从全球优质信息源中筛选,几分钟了解当天最值得关注的观点。